# ऑटोएन्कोडर्स
जब हम CNNs को ट्रेन करते हैं, तो एक समस्या यह होती है कि हमें बहुत सारे लेबल वाले डेटा की आवश्यकता होती है। इमेज क्लासिफिकेशन के मामले में, हमें इमेज को अलग-अलग क्लास में विभाजित करना होता है, जो एक मैनुअल प्रक्रिया है।
## [प्री-लेक्चर क्विज़](https://red-field-0a6ddfd03.1.azurestaticapps.net/quiz/109)
हालांकि, हम कच्चे (अनलेबल्ड) डेटा का उपयोग CNN फीचर एक्सट्रैक्टर्स को ट्रेन करने के लिए करना चाह सकते हैं, जिसे **सेल्फ-सुपरवाइज्ड लर्निंग** कहा जाता है। लेबल्स के बजाय, हम ट्रेनिंग इमेज को नेटवर्क इनपुट और आउटपुट दोनों के रूप में उपयोग करेंगे। **ऑटोएन्कोडर** का मुख्य विचार यह है कि हमारे पास एक **एन्कोडर नेटवर्क** होगा जो इनपुट इमेज को किसी **लेटेंट स्पेस** (आमतौर पर यह एक छोटे आकार का वेक्टर होता है) में बदल देगा, और फिर एक **डिकोडर नेटवर्क** होगा, जिसका लक्ष्य मूल इमेज को पुनर्निर्मित करना होगा।
> ✅ एक [ऑटोएन्कोडर](https://wikipedia.org/wiki/Autoencoder) "एक प्रकार का आर्टिफिशियल न्यूरल नेटवर्क है जिसका उपयोग अनलेबल्ड डेटा के कुशल कोडिंग को सीखने के लिए किया जाता है।"
चूंकि हम ऑटोएन्कोडर को मूल इमेज से अधिकतम जानकारी को कैप्चर करने के लिए ट्रेन कर रहे हैं ताकि सटीक पुनर्निर्माण हो सके, नेटवर्क इनपुट इमेज का सबसे अच्छा **एम्बेडिंग** खोजने की कोशिश करता है ताकि उसका अर्थ कैप्चर किया जा सके।
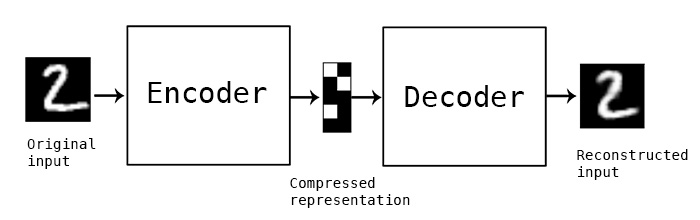
> इमेज [Keras ब्लॉग](https://blog.keras.io/building-autoencoders-in-keras.html) से
## ऑटोएन्कोडर्स का उपयोग करने के परिदृश्य
हालांकि मूल इमेज को पुनर्निर्मित करना अपने आप में उपयोगी नहीं लगता, लेकिन कुछ परिदृश्य हैं जहां ऑटोएन्कोडर्स विशेष रूप से उपयोगी होते हैं:
* **विज़ुअलाइज़ेशन के लिए इमेज का आयाम कम करना** या **इमेज एम्बेडिंग को ट्रेन करना**। आमतौर पर ऑटोएन्कोडर्स PCA से बेहतर परिणाम देते हैं, क्योंकि यह इमेज की स्थानिक प्रकृति और पदानुक्रमित विशेषताओं को ध्यान में रखता है।
* **डिनॉइज़िंग**, यानी इमेज से शोर को हटाना। क्योंकि शोर में बहुत सारी बेकार जानकारी होती है, ऑटोएन्कोडर इसे अपेक्षाकृत छोटे लेटेंट स्पेस में फिट नहीं कर सकता, और इस प्रकार यह केवल इमेज के महत्वपूर्ण हिस्से को कैप्चर करता है। जब हम डिनॉइज़र को ट्रेन करते हैं, तो हम मूल इमेज से शुरू करते हैं और ऑटोएन्कोडर के इनपुट के रूप में कृत्रिम रूप से जोड़े गए शोर वाली इमेज का उपयोग करते हैं।
* **सुपर-रिज़ॉल्यूशन**, यानी इमेज का रिज़ॉल्यूशन बढ़ाना। हम उच्च-रिज़ॉल्यूशन वाली इमेज से शुरू करते हैं और कम रिज़ॉल्यूशन वाली इमेज को ऑटोएन्कोडर इनपुट के रूप में उपयोग करते हैं।
* **जनरेटिव मॉडल्स**। एक बार जब हम ऑटोएन्कोडर को ट्रेन कर लेते हैं, तो डिकोडर भाग का उपयोग यादृच्छिक लेटेंट वेक्टर से नई वस्तुओं को बनाने के लिए किया जा सकता है।
## वेरिएशनल ऑटोएन्कोडर्स (VAE)
पारंपरिक ऑटोएन्कोडर्स इनपुट डेटा के आयाम को किसी तरह से कम करते हैं, इनपुट इमेज की महत्वपूर्ण विशेषताओं को समझते हैं। हालांकि, लेटेंट वेक्टर अक्सर ज्यादा समझ में नहीं आते। दूसरे शब्दों में, MNIST डेटासेट को उदाहरण के रूप में लेते हुए, यह समझना कि कौन से अंक विभिन्न लेटेंट वेक्टर से मेल खाते हैं, आसान नहीं है, क्योंकि पास के लेटेंट वेक्टर जरूरी नहीं कि एक ही अंक से मेल खाते हों।
दूसरी ओर, *जनरेटिव* मॉडल्स को ट्रेन करने के लिए लेटेंट स्पेस की कुछ समझ होना बेहतर होता है। यह विचार हमें **वेरिएशनल ऑटोएन्कोडर** (VAE) की ओर ले जाता है।
VAE वह ऑटोएन्कोडर है जो लेटेंट पैरामीटर्स के *सांख्यिकीय वितरण* की भविष्यवाणी करना सीखता है, जिसे **लेटेंट डिस्ट्रीब्यूशन** कहा जाता है। उदाहरण के लिए, हम चाहते हैं कि लेटेंट वेक्टर सामान्य रूप से zmean और zsigma (दोनों mean और standard deviation कुछ आयाम d के वेक्टर हैं) के साथ वितरित हों। VAE में एन्कोडर इन पैरामीटर्स की भविष्यवाणी करना सीखता है, और फिर डिकोडर इस वितरण से एक यादृच्छिक वेक्टर लेता है ताकि वस्तु को पुनर्निर्मित किया जा सके।
सारांश:
* इनपुट वेक्टर से, हम `z_mean` और `z_log_sigma` की भविष्यवाणी करते हैं (स्टैंडर्ड डिविएशन की बजाय, हम इसका लॉगरिदम भविष्यवाणी करते हैं)
* हम वितरण N(zmean,exp(zlog\_sigma)) से एक वेक्टर `sample` लेते हैं
* डिकोडर `sample` को इनपुट वेक्टर के रूप में उपयोग करके मूल इमेज को डिकोड करने की कोशिश करता है
 > इमेज [इस ब्लॉग पोस्ट](https://ijdykeman.github.io/ml/2016/12/21/cvae.html) से, लेखक: इसाक डाइकमैन
वेरिएशनल ऑटोएन्कोडर्स एक जटिल लॉस फंक्शन का उपयोग करते हैं, जिसमें दो भाग होते हैं:
* **रिकंस्ट्रक्शन लॉस** वह लॉस फंक्शन है जो यह दिखाता है कि पुनर्निर्मित इमेज लक्ष्य के कितनी करीब है (यह Mean Squared Error, या MSE हो सकता है)। यह सामान्य ऑटोएन्कोडर्स में उपयोग किए जाने वाले लॉस फंक्शन के समान है।
* **KL लॉस**, जो यह सुनिश्चित करता है कि लेटेंट वेरिएबल डिस्ट्रीब्यूशन सामान्य वितरण के करीब रहे। यह [कुलबैक-लिबलर डाइवर्जेंस](https://www.countbayesie.com/blog/2017/5/9/kullback-leibler-divergence-explained) की धारणा पर आधारित है - यह मेट्रिक दो सांख्यिकीय वितरणों की समानता का अनुमान लगाने के लिए उपयोग की जाती है।
VAEs का एक महत्वपूर्ण लाभ यह है कि वे हमें नई इमेज को अपेक्षाकृत आसानी से जनरेट करने की अनुमति देते हैं, क्योंकि हमें पता होता है कि लेटेंट वेक्टर को किस वितरण से सैंपल करना है। उदाहरण के लिए, यदि हम MNIST पर 2D लेटेंट वेक्टर के साथ VAE को ट्रेन करते हैं, तो हम लेटेंट वेक्टर के घटकों को बदलकर विभिन्न अंकों को प्राप्त कर सकते हैं:
 > इमेज [दिमित्री सोश्निकोव](http://soshnikov.com) द्वारा
ध्यान दें कि कैसे इमेज एक-दूसरे में बदलती हैं, क्योंकि हम लेटेंट पैरामीटर स्पेस के विभिन्न हिस्सों से लेटेंट वेक्टर प्राप्त करना शुरू करते हैं। हम इस स्पेस को 2D में भी विज़ुअलाइज़ कर सकते हैं:
 > इमेज [दिमित्री सोश्निकोव](http://soshnikov.com) द्वारा
## ✍️ अभ्यास: ऑटोएन्कोडर्स
इन संबंधित नोटबुक्स में ऑटोएन्कोडर्स के बारे में और जानें:
* [TensorFlow में ऑटोएन्कोडर्स](../../../../../lessons/4-ComputerVision/09-Autoencoders/AutoencodersTF.ipynb)
* [PyTorch में ऑटोएन्कोडर्स](../../../../../lessons/4-ComputerVision/09-Autoencoders/AutoEncodersPyTorch.ipynb)
## ऑटोएन्कोडर्स की विशेषताएं
* **डेटा-विशिष्ट** - ये केवल उसी प्रकार की इमेज पर अच्छा काम करते हैं, जिन पर इन्हें ट्रेन किया गया है। उदाहरण के लिए, यदि हम फूलों पर एक सुपर-रिज़ॉल्यूशन नेटवर्क को ट्रेन करते हैं, तो यह पोर्ट्रेट्स पर अच्छा काम नहीं करेगा। ऐसा इसलिए है क्योंकि नेटवर्क उच्च रिज़ॉल्यूशन वाली इमेज को ट्रेनिंग डेटासेट से सीखे गए फीचर्स से बारीक विवरण लेकर बनाता है।
* **लॉसी** - पुनर्निर्मित इमेज मूल इमेज के समान नहीं होती। लॉस की प्रकृति उस *लॉस फंक्शन* द्वारा परिभाषित होती है जिसका उपयोग ट्रेनिंग के दौरान किया गया है।
* **अनलेबल्ड डेटा** पर काम करता है
## [पोस्ट-लेक्चर क्विज़](https://red-field-0a6ddfd03.1.azurestaticapps.net/quiz/209)
## निष्कर्ष
इस पाठ में, आपने विभिन्न प्रकार के ऑटोएन्कोडर्स के बारे में सीखा जो AI वैज्ञानिकों के लिए उपलब्ध हैं। आपने सीखा कि उन्हें कैसे बनाना है और इमेज को पुनर्निर्मित करने के लिए उनका उपयोग कैसे करना है। आपने VAE के बारे में भी सीखा और नई इमेज जनरेट करने के लिए इसका उपयोग कैसे करना है।
## 🚀 चुनौती
इस पाठ में, आपने इमेज के लिए ऑटोएन्कोडर्स का उपयोग करना सीखा। लेकिन इन्हें संगीत के लिए भी उपयोग किया जा सकता है! मैजेंटा प्रोजेक्ट के [MusicVAE](https://magenta.tensorflow.org/music-vae) प्रोजेक्ट को देखें, जो संगीत को पुनर्निर्मित करना सीखने के लिए ऑटोएन्कोडर्स का उपयोग करता है। इस लाइब्रेरी के साथ कुछ [प्रयोग](https://colab.research.google.com/github/magenta/magenta-demos/blob/master/colab-notebooks/Multitrack_MusicVAE.ipynb) करें और देखें कि आप क्या बना सकते हैं।
## [पोस्ट-लेक्चर क्विज़](https://red-field-0a6ddfd03.1.azurestaticapps.net/quiz/208)
## समीक्षा और स्व-अध्ययन
संदर्भ के लिए, इन संसाधनों में ऑटोएन्कोडर्स के बारे में और पढ़ें:
* [Keras में ऑटोएन्कोडर्स बनाना](https://blog.keras.io/building-autoencoders-in-keras.html)
* [NeuroHive पर ब्लॉग पोस्ट](https://neurohive.io/ru/osnovy-data-science/variacionnyj-avtojenkoder-vae/)
* [वेरिएशनल ऑटोएन्कोडर्स समझाया गया](https://kvfrans.com/variational-autoencoders-explained/)
* [कंडीशनल वेरिएशनल ऑटोएन्कोडर्स](https://ijdykeman.github.io/ml/2016/12/21/cvae.html)
## असाइनमेंट
[TensorFlow का उपयोग करते हुए इस नोटबुक](../../../../../lessons/4-ComputerVision/09-Autoencoders/AutoencodersTF.ipynb) के अंत में एक 'टास्क' है - इसे अपना असाइनमेंट मानें।
**अस्वीकरण**:
यह दस्तावेज़ AI अनुवाद सेवा [Co-op Translator](https://github.com/Azure/co-op-translator) का उपयोग करके अनुवादित किया गया है। जबकि हम सटीकता के लिए प्रयासरत हैं, कृपया ध्यान दें कि स्वचालित अनुवाद में त्रुटियां या अशुद्धियां हो सकती हैं। मूल भाषा में उपलब्ध मूल दस्तावेज़ को प्रामाणिक स्रोत माना जाना चाहिए। महत्वपूर्ण जानकारी के लिए, पेशेवर मानव अनुवाद की सिफारिश की जाती है। इस अनुवाद के उपयोग से उत्पन्न किसी भी गलतफहमी या गलत व्याख्या के लिए हम उत्तरदायी नहीं हैं।