# Úvod do neuronových sítí. Vícevrstvý perceptron
V předchozí části jste se seznámili s nejjednodušším modelem neuronové sítě – jednovrstvým perceptronem, což je lineární model pro dvoutřídní klasifikaci.
V této části tento model rozšíříme do flexibilnějšího rámce, který nám umožní:
* provádět **vícetřídní klasifikaci** kromě dvoutřídní
* řešit **regresní úlohy** kromě klasifikace
* oddělovat třídy, které nejsou lineárně separovatelné
Také si vytvoříme vlastní modulární rámec v Pythonu, který nám umožní sestavovat různé architektury neuronových sítí.
## [Kvíz před přednáškou](https://ff-quizzes.netlify.app/en/ai/quiz/7)
## Formalizace strojového učení
Začněme formalizací problému strojového učení. Předpokládejme, že máme trénovací dataset **X** s popisky **Y**, a potřebujeme vytvořit model *f*, který bude poskytovat co nejpřesnější předpovědi. Kvalita předpovědí se měří pomocí **ztrátové funkce** ℒ. Často se používají následující ztrátové funkce:
* Pro regresní úlohy, kdy potřebujeme předpovědět číslo, můžeme použít **absolutní chybu** ∑i|f(x(i))-y(i)| nebo **kvadratickou chybu** ∑i(f(x(i))-y(i))2
* Pro klasifikaci používáme **0-1 ztrátu** (což je v podstatě totéž jako **přesnost** modelu) nebo **logistickou ztrátu**.
Pro jednovrstvý perceptron byla funkce *f* definována jako lineární funkce *f(x)=wx+b* (kde *w* je matice vah, *x* je vektor vstupních příznaků a *b* je vektor biasu). U různých architektur neuronových sítí může mít tato funkce složitější podobu.
> V případě klasifikace je často žádoucí získat pravděpodobnosti odpovídajících tříd jako výstup sítě. Pro převod libovolných čísel na pravděpodobnosti (např. pro normalizaci výstupu) často používáme funkci **softmax** σ, a funkce *f* se stává *f(x)=σ(wx+b)*.
V definici *f* výše se *w* a *b* nazývají **parametry** θ=⟨*w,b*⟩. Na základě datasetu ⟨**X**,**Y**⟩ můžeme vypočítat celkovou chybu na celém datasetu jako funkci parametrů θ.
> ✅ **Cílem trénování neuronové sítě je minimalizovat chybu změnou parametrů θ**
## Optimalizace pomocí gradientního sestupu
Existuje známá metoda optimalizace funkcí nazývaná **gradientní sestup**. Myšlenka spočívá v tom, že můžeme vypočítat derivaci (v multidimenzionálním případě nazývanou **gradient**) ztrátové funkce vzhledem k parametrům a měnit parametry tak, aby se chyba snižovala. To lze formalizovat následovně:
* Inicializujte parametry náhodnými hodnotami w(0), b(0)
* Opakujte následující krok mnohokrát:
- w(i+1) = w(i)-η∂ℒ/∂w
- b(i+1) = b(i)-η∂ℒ/∂b
Během trénování by měly být optimalizační kroky počítány s ohledem na celý dataset (pamatujte, že ztráta se počítá jako součet přes všechny trénovací vzorky). V praxi však bereme malé části datasetu nazývané **minibatch** a počítáme gradienty na základě podmnožiny dat. Protože je podmnožina pokaždé vybírána náhodně, nazývá se tato metoda **stochastický gradientní sestup** (SGD).
## Vícevrstvé perceptrony a zpětná propagace
Jednovrstvá síť, jak jsme viděli výše, je schopna klasifikovat lineárně separovatelné třídy. Pro vytvoření bohatšího modelu můžeme kombinovat několik vrstev sítě. Matematicky to znamená, že funkce *f* bude mít složitější podobu a bude vypočítávána v několika krocích:
* z1=w1x+b1
* z2=w2α(z1)+b2
* f = σ(z2)
Zde α je **nelineární aktivační funkce**, σ je softmax funkce a parametry θ=<*w1,b1,w2,b2*>.
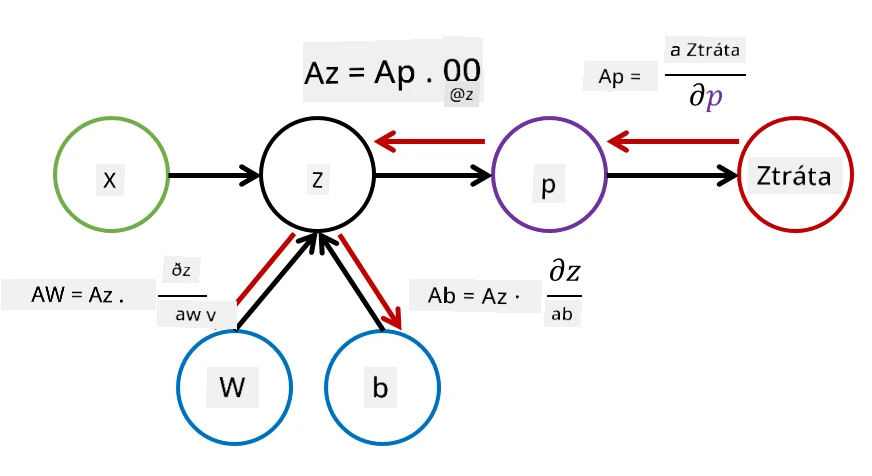
Algoritmus gradientního sestupu zůstane stejný, ale výpočet gradientů bude složitější. Na základě pravidla řetězového diferenciálu můžeme derivace vypočítat takto:
* ∂ℒ/∂w2 = (∂ℒ/∂σ)(∂σ/∂z2)(∂z2/∂w2)
* ∂ℒ/∂w1 = (∂ℒ/∂σ)(∂σ/∂z2)(∂z2/∂α)(∂α/∂z1)(∂z1/∂w1)
> ✅ Pravidlo řetězového diferenciálu se používá k výpočtu derivací ztrátové funkce vzhledem k parametrům.
Všimněte si, že levá část všech těchto výrazů je stejná, a proto můžeme efektivně počítat derivace počínaje ztrátovou funkcí a postupovat "zpětně" skrze výpočetní graf. Proto se metoda trénování vícevrstvého perceptronu nazývá **zpětná propagace** nebo 'backprop'.
 > TODO: citace obrázku
> ✅ Zpětnou propagaci probereme mnohem podrobněji v našem příkladovém notebooku.
## Závěr
V této lekci jsme vytvořili vlastní knihovnu neuronových sítí a použili jsme ji pro jednoduchou dvourozměrnou klasifikační úlohu.
## 🚀 Výzva
V přiloženém notebooku implementujete vlastní rámec pro vytváření a trénování vícevrstvých perceptronů. Budete moci podrobně vidět, jak moderní neuronové sítě fungují.
Pokračujte do notebooku [OwnFramework](OwnFramework.ipynb) a projděte si jej.
## [Kvíz po přednášce](https://ff-quizzes.netlify.app/en/ai/quiz/8)
## Přehled a samostudium
Zpětná propagace je běžný algoritmus používaný v AI a ML, stojí za to ji [prostudovat podrobněji](https://wikipedia.org/wiki/Backpropagation).
## [Úkol](lab/README.md)
V tomto laboratorním cvičení máte za úkol použít rámec, který jste vytvořili v této lekci, k řešení klasifikace ručně psaných číslic z datasetu MNIST.
* [Instrukce](lab/README.md)
* [Notebook](lab/MyFW_MNIST.ipynb)
---