# Sissejuhatus tehisnärvivõrkudesse. Mitmekihiline perceptron
Eelmises osas õppisite tundma kõige lihtsamat tehisnärvivõrgu mudelit – ühekihilist perceptronit, mis on lineaarne kahe klassi klassifitseerimise mudel.
Selles osas laiendame seda mudelit paindlikumaks raamistikuks, mis võimaldab:
* teha **mitme klassi klassifikatsiooni** lisaks kahe klassi klassifikatsioonile
* lahendada **regressiooniprobleeme** lisaks klassifikatsioonile
* eristada klasse, mis ei ole lineaarselt eristatavad
Samuti arendame välja oma modulaarse raamistiku Pythonis, mis võimaldab meil luua erinevaid tehisnärvivõrgu arhitektuure.
## [Eelloengu viktoriin](https://ff-quizzes.netlify.app/en/ai/quiz/7)
## Masinõppe formaliseerimine
Alustame masinõppe probleemi formaliseerimisest. Oletame, et meil on treeningandmestik **X** koos siltidega **Y**, ja peame looma mudeli *f*, mis teeb kõige täpsemaid ennustusi. Ennustuste kvaliteeti mõõdetakse **kaofunktsiooni** ℒ abil. Sageli kasutatakse järgmisi kaofunktsioone:
* Regressiooniprobleemi puhul, kui peame ennustama arvu, saame kasutada **absoluutset viga** ∑i|f(x(i))-y(i)| või **ruutviga** ∑i(f(x(i))-y(i))2
* Klassifikatsiooni puhul kasutame **0-1 kaotust** (mis sisuliselt on sama mis mudeli **täpsus**) või **logistilist kaotust**.
Ühekihilise perceptroni puhul oli funktsioon *f* defineeritud kui lineaarne funktsioon *f(x)=wx+b* (kus *w* on kaalude maatriks, *x* on sisendite tunnuste vektor ja *b* on nihkevektor). Erinevate tehisnärvivõrgu arhitektuuride puhul võib see funktsioon olla keerukama kujuga.
> Klassifikatsiooni puhul on sageli soovitav saada võrgu väljundina klasside tõenäosused. Arvude teisendamiseks tõenäosusteks (nt väljundi normaliseerimiseks) kasutame sageli **softmax** funktsiooni σ, ja funktsioon *f* muutub *f(x)=σ(wx+b)*
Ülaltoodud *f* definitsioonis nimetatakse *w* ja *b* **parameetriteks** θ=⟨*w,b*⟩. Arvestades andmestikku ⟨**X**,**Y**⟩, saame arvutada kogu andmestiku vea parameetrite θ funktsioonina.
> ✅ **Tehisnärvivõrgu treenimise eesmärk on minimeerida viga, muutes parameetreid θ**
## Gradientlanguse optimeerimine
On olemas tuntud funktsiooni optimeerimise meetod, mida nimetatakse **gradientlanguseks**. Idee seisneb selles, et saame arvutada kaofunktsiooni tuletise (mitmemõõtmelisel juhul nimetatakse seda **gradientiks**) parameetrite suhtes ja muuta parameetreid nii, et viga väheneks. Seda saab formaliseerida järgmiselt:
* Algväärtusta parameetrid juhuslike väärtustega w(0), b(0)
* Korda järgmist sammu mitu korda:
- w(i+1) = w(i)-η∂ℒ/∂w
- b(i+1) = b(i)-η∂ℒ/∂b
Treeningu ajal peaksid optimeerimissammud olema arvutatud kogu andmestikku arvestades (pidage meeles, et kaotus arvutatakse kõigi treeningnäidete summa põhjal). Kuid reaalses elus võtame andmestikust väikeseid osi, mida nimetatakse **minipartiideks**, ja arvutame gradientid andmealamkogumi põhjal. Kuna alamkogum valitakse iga kord juhuslikult, nimetatakse sellist meetodit **stohhastiliseks gradientlanguseks** (SGD).
## Mitmekihilised perceptronid ja tagasilevik
Ühekihiline võrk, nagu me eespool nägime, suudab klassifitseerida lineaarselt eristatavaid klasse. Rikkama mudeli loomiseks saame kombineerida mitu võrgu kihti. Matemaatiliselt tähendaks see, et funktsioon *f* oleks keerukama kujuga ja arvutataks mitmes etapis:
* z1=w1x+b1
* z2=w2α(z1)+b2
* f = σ(z2)
Siin α on **mittelineaarne aktivatsioonifunktsioon**, σ on softmax funktsioon ja parameetrid θ=<*w1,b1,w2,b2*>.
Gradientlanguse algoritm jääb samaks, kuid gradientide arvutamine muutub keerulisemaks. Arvestades ahel-diferentseerimise reeglit, saame tuletised arvutada järgmiselt:
* ∂ℒ/∂w2 = (∂ℒ/∂σ)(∂σ/∂z2)(∂z2/∂w2)
* ∂ℒ/∂w1 = (∂ℒ/∂σ)(∂σ/∂z2)(∂z2/∂α)(∂α/∂z1)(∂z1/∂w1)
> ✅ Ahel-diferentseerimise reeglit kasutatakse kaofunktsiooni tuletiste arvutamiseks parameetrite suhtes.
Pange tähele, et kõigi nende avaldiste vasakpoolne osa on sama, ja seega saame tuletised tõhusalt arvutada, alustades kaofunktsioonist ja liikudes "tagasi" läbi arvutusgraafi. Seetõttu nimetatakse mitmekihilise perceptroni treenimise meetodit **tagasilevikuks** ehk 'backprop'.
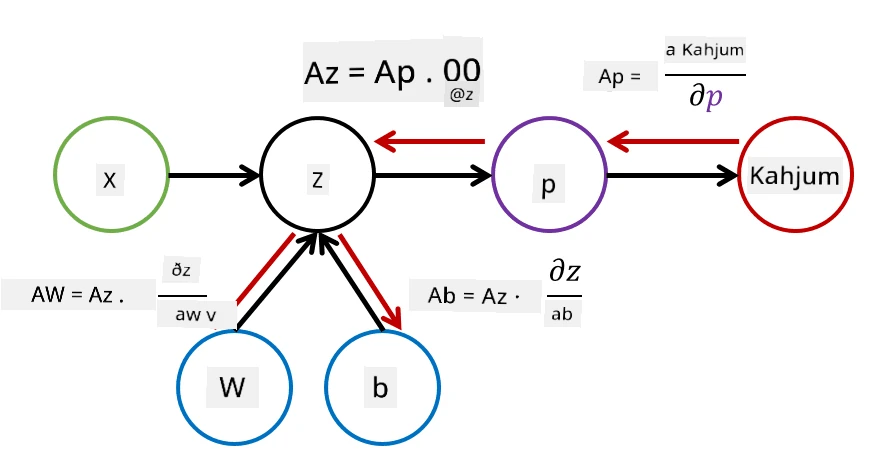 > TODO: pildi viide
> ✅ Katame tagasileviku palju detailsemalt meie näidisnotebookis.
## Kokkuvõte
Selles õppetunnis ehitasime oma tehisnärvivõrgu raamistiku ja kasutasime seda lihtsa kahemõõtmelise klassifikatsiooniprobleemi lahendamiseks.
## 🚀 Väljakutse
Kaasaolevas notebookis rakendate oma raamistiku mitmekihiliste perceptronite loomiseks ja treenimiseks. Näete üksikasjalikult, kuidas kaasaegsed tehisnärvivõrgud töötavad.
Jätkake [OwnFramework](OwnFramework.ipynb) notebookiga ja töötage see läbi.
## [Järelloengu viktoriin](https://ff-quizzes.netlify.app/en/ai/quiz/8)
## Ülevaade ja iseseisev õppimine
Tagasilevik on tehisintellekti ja masinõppe valdkonnas levinud algoritm, mida tasub [täpsemalt uurida](https://wikipedia.org/wiki/Backpropagation).
## [Ülesanne](lab/README.md)
Selles praktikumis palutakse teil kasutada selles õppetunnis loodud raamistikku MNIST käsitsi kirjutatud numbrite klassifikatsiooni lahendamiseks.
* [Juhised](lab/README.md)
* [Notebook](lab/MyFW_MNIST.ipynb)
---
**Lahtiütlus**:
See dokument on tõlgitud, kasutades AI tõlketeenust [Co-op Translator](https://github.com/Azure/co-op-translator). Kuigi püüame tagada täpsust, palun arvestage, et automaatsed tõlked võivad sisaldada vigu või ebatäpsusi. Algne dokument selle algkeeles tuleks lugeda autoriteetseks allikaks. Olulise teabe puhul on soovitatav kasutada professionaalset inimtõlget. Me ei vastuta selle tõlke kasutamisest tulenevate arusaamatuste või valede tõlgenduste eest.