# Introduzione alle Reti Neurali. Perceptron Multistrato
Nella sezione precedente, hai imparato il modello di rete neurale più semplice: il perceptron a uno strato, un modello lineare per la classificazione a due classi.
In questa sezione estenderemo questo modello in un framework più flessibile, che ci permetterà di:
* eseguire la **classificazione multi-classe** oltre alla classificazione a due classi
* risolvere problemi di **regressione** oltre alla classificazione
* separare classi che non sono linearmente separabili
Svilupperemo inoltre un framework modulare in Python che ci consentirà di costruire diverse architetture di reti neurali.
## [Quiz pre-lezione](https://ff-quizzes.netlify.app/en/ai/quiz/7)
## Formalizzazione del Machine Learning
Iniziamo formalizzando il problema del Machine Learning. Supponiamo di avere un dataset di addestramento **X** con etichette **Y**, e dobbiamo costruire un modello *f* che produca previsioni il più accurate possibile. La qualità delle previsioni viene misurata tramite la **funzione di perdita** ℒ. Le seguenti funzioni di perdita sono spesso utilizzate:
* Per problemi di regressione, quando dobbiamo prevedere un numero, possiamo usare l'**errore assoluto** ∑i|f(x(i))-y(i)|, o l'**errore quadratico** ∑i(f(x(i))-y(i))2
* Per la classificazione, utilizziamo la **perdita 0-1** (che è essenzialmente la stessa cosa dell'**accuratezza** del modello), o la **perdita logistica**.
Per il perceptron a uno strato, la funzione *f* era definita come una funzione lineare *f(x)=wx+b* (qui *w* è la matrice dei pesi, *x* è il vettore delle caratteristiche di input, e *b* è il vettore di bias). Per diverse architetture di reti neurali, questa funzione può assumere una forma più complessa.
> Nel caso della classificazione, spesso è desiderabile ottenere le probabilità delle classi corrispondenti come output della rete. Per convertire numeri arbitrari in probabilità (ad esempio per normalizzare l'output), utilizziamo spesso la funzione **softmax** σ, e la funzione *f* diventa *f(x)=σ(wx+b)*
Nella definizione di *f* sopra, *w* e *b* sono chiamati **parametri** θ=⟨*w,b*⟩. Dato il dataset ⟨**X**,**Y**⟩, possiamo calcolare un errore complessivo sull'intero dataset come funzione dei parametri θ.
> ✅ **L'obiettivo dell'addestramento della rete neurale è minimizzare l'errore variando i parametri θ**
## Ottimizzazione con Discesa del Gradiente
Esiste un metodo noto per l'ottimizzazione delle funzioni chiamato **discesa del gradiente**. L'idea è che possiamo calcolare una derivata (nel caso multidimensionale chiamata **gradiente**) della funzione di perdita rispetto ai parametri, e variare i parametri in modo tale che l'errore diminuisca. Questo può essere formalizzato come segue:
* Inizializzare i parametri con alcuni valori casuali w(0), b(0)
* Ripetere il seguente passo molte volte:
- w(i+1) = w(i)-η∂ℒ/∂w
- b(i+1) = b(i)-η∂ℒ/∂b
Durante l'addestramento, i passi di ottimizzazione dovrebbero essere calcolati considerando l'intero dataset (ricorda che la perdita viene calcolata come somma su tutti i campioni di addestramento). Tuttavia, nella pratica prendiamo piccole porzioni del dataset chiamate **minibatch**, e calcoliamo i gradienti basandoci su un sottoinsieme di dati. Poiché il sottoinsieme viene scelto casualmente ogni volta, tale metodo è chiamato **discesa del gradiente stocastica** (SGD).
## Perceptron Multistrato e Backpropagation
La rete a uno strato, come abbiamo visto sopra, è in grado di classificare classi linearmente separabili. Per costruire un modello più ricco, possiamo combinare diversi strati della rete. Matematicamente ciò significherebbe che la funzione *f* avrebbe una forma più complessa e verrebbe calcolata in diversi passaggi:
* z1=w1x+b1
* z2=w2α(z1)+b2
* f = σ(z2)
Qui, α è una **funzione di attivazione non lineare**, σ è una funzione softmax, e i parametri θ=<*w1,b1,w2,b2*>.
L'algoritmo di discesa del gradiente rimarrebbe lo stesso, ma sarebbe più difficile calcolare i gradienti. Dato il principio della derivazione a catena, possiamo calcolare le derivate come:
* ∂ℒ/∂w2 = (∂ℒ/∂σ)(∂σ/∂z2)(∂z2/∂w2)
* ∂ℒ/∂w1 = (∂ℒ/∂σ)(∂σ/∂z2)(∂z2/∂α)(∂α/∂z1)(∂z1/∂w1)
> ✅ Il principio della derivazione a catena viene utilizzato per calcolare le derivate della funzione di perdita rispetto ai parametri.
Nota che la parte più a sinistra di tutte queste espressioni è la stessa, e quindi possiamo calcolare efficacemente le derivate partendo dalla funzione di perdita e andando "indietro" attraverso il grafo computazionale. Pertanto, il metodo di addestramento di un perceptron multistrato è chiamato **backpropagation**, o 'backprop'.
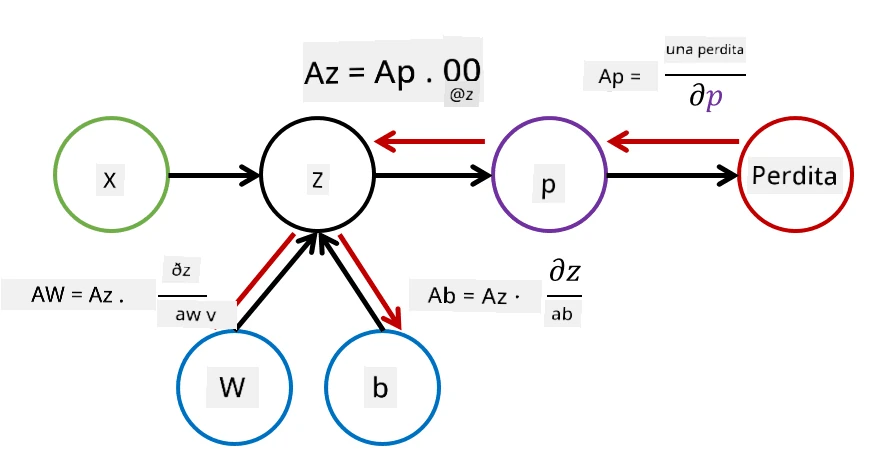 > TODO: citazione immagine
> ✅ Approfondiremo il backpropagation in modo molto più dettagliato nel nostro esempio nel notebook.
## Conclusione
In questa lezione, abbiamo costruito la nostra libreria di reti neurali e l'abbiamo utilizzata per un semplice compito di classificazione bidimensionale.
## 🚀 Sfida
Nel notebook allegato, implementerai il tuo framework per costruire e addestrare perceptron multistrato. Potrai vedere in dettaglio come operano le reti neurali moderne.
Procedi al notebook [OwnFramework](OwnFramework.ipynb) e segui le istruzioni.
## [Quiz post-lezione](https://ff-quizzes.netlify.app/en/ai/quiz/8)
## Revisione e Studio Autonomo
Il backpropagation è un algoritmo comune utilizzato in AI e ML, vale la pena studiarlo [in modo più approfondito](https://wikipedia.org/wiki/Backpropagation)
## [Compito](lab/README.md)
In questo laboratorio, ti viene chiesto di utilizzare il framework che hai costruito in questa lezione per risolvere la classificazione delle cifre scritte a mano del dataset MNIST.
* [Istruzioni](lab/README.md)
* [Notebook](lab/MyFW_MNIST.ipynb)
---